
文 / 张钰勃,摩尔线程联合创始人兼CTO
根据2026年4月22日至23日基石资本峰会分享整理,文章仅代表作者本人观点
“
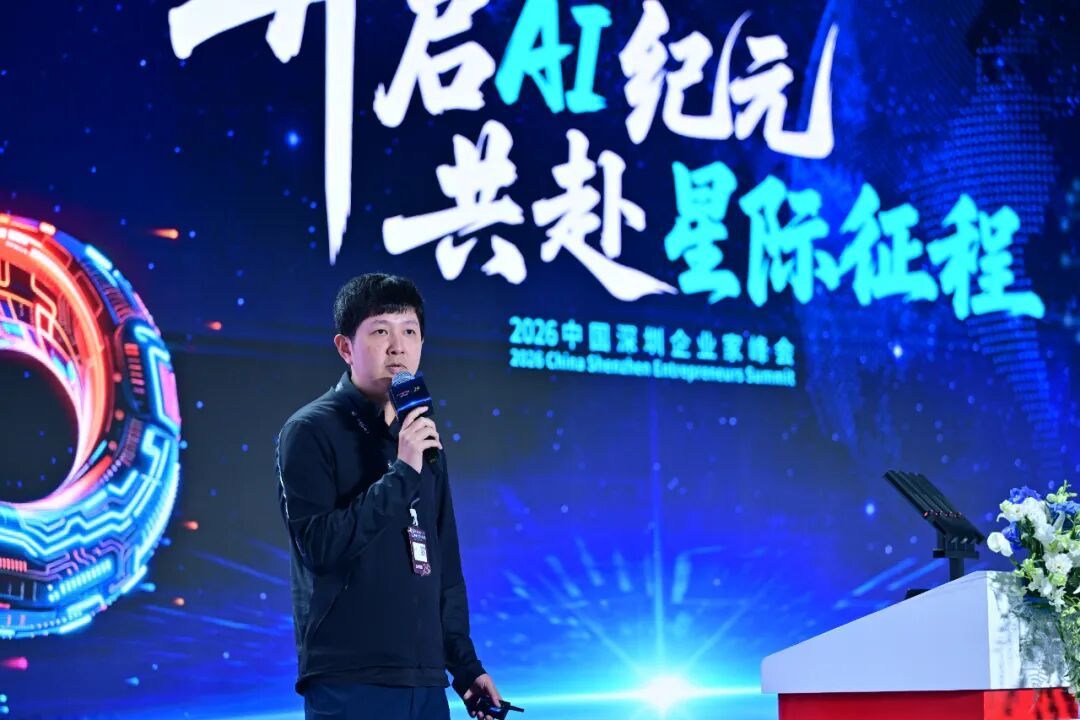
4月22至23日,由基石资本主办的“2026中国深圳企业家峰会”在深圳成功举行。本次峰会以“开启AI纪元,共赴星际征程”为主题,聚焦人工智能、算力、自动驾驶、具身智能、商业航天、量子科技、可控核聚变等关键前沿领域,摩尔线程联合创始人兼CTO张钰勃发表了“国产AI算力技术演进与未来”的主题演讲。以下为详细内容。
各位嘉宾,大家好。首先感谢基石资本的邀请。基石资本是摩尔线程的早期投资方,曾在我们的创业过程中给予了很大支持。
我今天代表摩尔线程,和大家分享我们在AI算力方面的关注点,尤其是为什么我们坚持聚焦大模型训练的价值。
首先分享我的核心观点:
第一,关于AI算力。在早期的认知中,芯片设计公司交付的是单一芯片,但我们逐渐发现仅靠芯片是不够的,必须向系统化迈进。为什么要强调系统?因为随着大模型的爆发,模型参数规模越来越大,单颗芯片已无法容纳,系统化部署成为必然。然而,单一服务器系统主要解决的是分布式推理问题,真正的技术门槛在于大规模训练。因此,我们必须从系统进一步走向集群,且集群需达到数万卡的规模,才能满足研发优质大模型的需求。虽然训练与推理都很重要,但从技术壁垒来看,训练具备更高的战略价值。
第二,从产业上下游的投资视角来看,我们将持续聚焦训练的能力。
01
国产AI算力技术演进的三个时期
第一时期:萌芽期。里程碑事件应首推谷歌 AlphaGo 战胜围棋世界冠军李世石,这一事件引发了业界对人工智能的深度思考。同期,国内算力产业也开始发力:2016 年寒武纪发布了首款商用芯片;2018 年,华为随后推出了达芬奇架构。然而在那个时期,芯片架构普遍以 ASIC 和 NPU 为主,且主要应用于推理场景,模型训练领域依然由英伟达主导。这一阶段整体以小规模验证为主,在综合实力上与国际顶尖算力企业仍存在差距。
第二时期:发展期(2019年之后到2023年)。业界逐渐察觉到ASIC与NPU架构在实际应用中的局限性。由于通用性不足,此类单一架构难以适应几乎每个月甚至每周都在变化的AI算法迭代。在此背景下,出现了多家GPU创业公司,其中包括摩尔线程、天数、沐曦、壁仞等。尽管国产推理芯片的出货量也在逐步攀升,但从市场应用来看,芯片用途仍主要集中在推理场景。
第三时期:成熟期。我将大模型出现后的阶段定义为“成熟期”或“突破期”。这一时期的突破并非指全面赶超英伟达,而是体现在诸多单点技术上的点状突破。尤其是 ChatGPT 问世后,行业开始集体关注并攻坚大规模训练能力。以摩尔线程为例,我们在2024 年推出的 MTT S5000 芯片,真正具备了大模型训练能力。与此同时,异构计算逐渐成为推理架构的主流,软硬件协同优化也迈入了深水区。
现阶段,摩尔线程的自身定位是在万卡级别的大规模训练上实现突破。
从第二个维度看,产品的交付形态发生了显著变化。早期的 AI 算力交付多以加速卡为主;2022 年以后,随着模型规模不断扩张,服务器逐渐成为主流交付模式。芯片厂商之所以开始做定制化服务器架构,是因为当模型规模突破单芯片的承载极限时,就要依靠单机内8颗甚至16 颗芯片的协同操作。这就像执行一项任务:简单的任务单人即可胜任,而复杂的任务则需要团队协作。即便团队成员个人能力出众,如果缺乏高效的协同机制,依然难以达成团队目标。因此,为了实现极致的协同,卡间通信技术显得尤为关键,正如英伟达 GPU 所采用的 NVLink 技术。
摩尔线程自研了 MTLink 技术,旨在实现我们芯片间的高速互联,因为传统的 PCIe 协议已难以满足算力爆发式增长的需求。实现数张至十几张卡之间的通信相对容易,真正的技术门槛在于大规模训练。在训练场景下,算力需求已不再局限于单机规模,核心挑战在于如何驱动上万张芯片高度协同,从而生产出高质量的大模型。万卡集群的训练难度比推理高出两到三个数量级;要确保数万颗芯片在通信过程中保持步调一致,并最大化算力利用率、避免有效算力损耗,是一项极具挑战性的系统工程。
2024年至今,我们一直在反复打磨的一件事情,就是实践怎样端到端地交付一个智算集群。这一集群系统不仅涵盖计算核心,更深度集成了高速互联、网络架构与分布式存储等要素。我们始终关注的核心挑战在于:在交付万P级算力资源的基础上,如何通过系统级的协同优化,将算力效率发挥到极致。
02
AI市场发展迅速,但用户愿意付费的是优质模型
当前,AI市场快速增长,具体数据不再展开。我想强调的是:下游需求才是产业发展的根本动力。AI市场若要维持良好的增长态势,根源在于必须不断涌现高质量的AI应用。用户只会为真正创造价值的AI服务买单,而应用体验好不好,本质上取决于底层模型训练的质量。
可以说,是终端用户的选择在推动整个行业发展,用户只愿意为优质模型付费,以当前火热的Claude模型为例,用户可能愿意每个月花200美金包月使用,但如果是一个免费的模型,体验不好的话,用户最终也不会去使用。
那么,如何才能训练出优质模型?这高度依赖于高质量的训练平台,从而打造出性能卓越、能切实解决实际问题的顶尖大模型。当前,模型训练成本正呈指数级增长,同时伴随着极高的资本投入与技术壁垒。只有有训练出最先进的模型,才能驱动市场的高溢价。归根结底,用户真正愿意付费的,是模型的聪明程度。
现在业界都在讨论AI是否能取代人类,在我看来,AI或许会逐步取代一些基础性、重复性的工作,但涉及高认知、尤其是决策性的核心环节,依然具有不可替代性。因此,AI真正的价值体现在能力,而不是简单的数量。
如果把训练比作高利润的军火商,推理就像是薄利的快消品。我们的预判是,未来推理的市场会非常庞大,但前提是体验要好,而好体验的前提是高质量模型训练质量。因此,从投资逻辑看,不应只看到推理市场体量本身,更要关注训练这一技术与价值的制高点。
摩尔线程始终认为,我们要做真正困难但有价值的事。创业过程中我们持续在思考,作为AI算力基础设施企业,能在什么地方发挥最大价值?现在我们坚信,打造一个能实现高质量训练的算力设施平台,就能真正创造价值。
(1)路线:坚持以全功能GPU统一系统架构为基础,支持AI训推、物理仿真、图形渲染、科学计算等全栈GPU能力,目标是全方位替代CUDA生态。
(2)能力:摩尔线程2024年发布的芯片产品,首次在单芯片上突破1P浮点算力,这在国内应该是首创。同时,Attention这类算子的利用率最高能达到95%,作为比较,H系列的利用率是75%左右。这充分说明我们在架构上的先进性。
(3)集群落地:摩尔线程去年已成功落地万卡智算集群,并验证了万亿规模参数模型的训练精度。目前整体训练还在持续进行调优和优化中。
(4)壁垒构建:摩尔线程首先验证了万卡集群的技术与工程化能力;其次,我们还完成了万亿参数大模型的精度验证;再者,我们会坚持全功能GPU路线,做到全精度、无功能缺失,这样才能全方位承接CUDA生态。最后,我们整个软件都采用开源形式,致力于为开发者提供最好的国内工具平台。
过去两年,摩尔线程在训练上端到端完成了34项模型的训练和精度验证,覆盖了多维度的合作方,包括云厂商、新能源车企和科研机构,领域涵盖大模型、多模态、智驾和视觉模型。举个例子,我们基于7680张卡训练8TB数据,MMLU评测可以和H系列持平,整个过程中Loss曲线误差最高为0.6%,集群扩展效率达到95%,有效训练时间占比超过95%。这相当于管理一个近万人的团队,并且高效协同地达成一个重要目标。
03
关于未来技术趋势的五点共识
第一,先进封装。包括2.5D、3D封装技术在内,目前已在普遍应用阶段。另外就是大家关注的HBM(高带宽内存)、CoWoS封装和Chiplet(芯粒)技术。此外,CPO技术的发展,也将进一步提升算力集成度,通过光互联实现更高密度的通讯带宽。
第二,异构计算。通过CPU、GPU、网络以及ASIC、LPU等多种处理器的深度协同,实现针对不同任务负载的最优性价比。
第三,存算一体:让存储与计算靠得更近,并且通过三维堆叠等芯片工艺,可以实现更高的计算效率。
第四,绿色算力。涵盖了从液冷技术、电源使用效率(PUE)优化到高压直流供电等全链路创新,从而提升整个能源系统的转化率。
第五,算力即服务。算力即服务正成为行业新常态:当大模型公司通过输出Token来创造价值时,背后需要的是庞大的GPU云基础设施。算力服务商正是这一生产流程中的核心工厂。
回顾一下核心结论。
第一,AI算力的交付已经走向系统化、集群化。AI算力厂商的真正价值,在于能否实现万卡乃至十万卡规模集群的交付。这种交付并非简单的硬件堆叠,其核心门槛在于如何让海量算力卡实现深度协同,将碎片化的计算资源转化为高效、稳定的训练能力,从而在系统级层面提升算力利用率。
第二,训练与推理正走向价值分化。训练会是一个高利润的行业,但推理会是一个利润微薄的红海,量非常大,但不一定赚得到钱。在AI算力领域,训练与推理正展现出截然不同的商业逻辑:大模型训练凭借其极高的技术门槛与资源稀缺性,将长期处于价值链顶端,维持高利润属性;而推理侧尽管拥有极其庞大的市场容量,但随着竞争加剧,正迅速演变为低毛利的“红海”市场,呈现出“规模巨大却盈利艰难”的特征。
第三,训练能力是AI体验的关键指标。因为训练能力决定了AI应用的质量,而用户真正愿意花钱的,是高质量的AI应用。底层训练能力直接决定了AI应用的质量上限。 在真实的市场环境中,用户真正愿意花钱的,是高质量的AI应用。因此,训练端不仅是技术的起点,更是商业价值的源头。
我的分享就到这里,谢谢大家。
一个残酷的事实:你的AI投入,可能正在打水漂
MIT《2025年AI商业报告》显示:95%的企业在生成式AI上尚未获得可衡量回报,成功进入生产环境并产生财务影响的试点项目,仅占5%。
不是模型不够强,不是数据不够多——而是绝大多数企业从第一步就走错了。
我们在辅导了多家万亿级企业后,得出结论:企业AI转型的失败,根源在于对AI的五大认知迷局——
❌以为AI无所不能 → 结果被“幻觉”坑得不敢再用;
❌把互联网C端的“平均解”套用到B端 → 企业竞争靠的是顶尖能力放大,不是行业平均水平;
❌迷信自研大模型 → 训练GPT-4级模型成本7.2亿元起,绝大多数企业根本不需要;
❌用过某产品不好用就全盘否定 → 不同模型能力差异巨大,刻板印象让你错失战机;
❌认为AI只能做办公助手 → 真正的价值在生产、销售、供应链等核心价值链。
2026年5月22日-24日,华夏基石AI战略总裁班第四期,首次同时拆解两套成功范式:美的集团的AI智造力跃迁 + 华夏基石的“专家×AI×组织进化”落地体系(万亿级企业落地实践)。
这不是科普课,而是一场已经验证的实战复盘。
美的经验:AI驱动下的智造力跃迁,及AI降本7亿的底层逻辑
将围绕美的“科技领先、数智驱动”战略主轴,系统拆解其从百亿到四千亿的智能化转型路径。
机制设计:美云智数营销战略与业务运营专家张治国剖析“一个美的、一个体系、一个标准”的组织运营底层逻辑,破解规模企业“管控与活力”的平衡难题。
流程变革:数字化专家、美云智数副总裁李亮复盘“632”项目——如何统一流程、数据与IT系统,为数字化转型打下根基。
卓越运营:数据运营专家、美云智数副总裁兼首席客户官魏晓刚展示全价值链数字化运营体系,实现订单流、资金流、物流“三流合一”。
精益管理:美云智数行业生态部总经理(曾任集团精益负责人)邢成玉深度解读方洪波所认可的MBS体系(丹纳赫DBS升级版)——“效率是第一性原理,精益管理与算法精度融合”,揭秘MBS如何为灯塔工厂筑基。方洪波曾直言:未来企业要将最先进的数字化、智能化与管理体系打通。未来的效率竞争,既是精益管理能力的竞争,也是数据密度与算法精度的较量。
AI实践:美云智数AIGC专家陈淑敏全面拆解美擎智能体在研发、生产、供应链、营销等场景的落地成效,还原2025年降本7亿元的实战路径。
某万亿级企业实践:我们如何驯服AI
首次公开我们带领企业跑通AI价值链闭环的独家方法论(万亿级企业已验证)。这是在咨询实战中“烧掉几千万”才总结出来的认知。
破局核心一:专家能力蒸馏
企业真正的护城河,不在数据量,而在少数专家脑中不可复制的判断力。但专家天然抗拒输出经验——担心被替代、KPI不支持、知识高度隐性。华夏基石的方法:通过逆向工程,把专家的直觉判断拆解为思维SOP,再转化为AI可学习的结构化能力,将顶尖专家70%的判断力复制给整个团队。
破局核心二:原子级任务拆解
AI幻觉的本质是什么?“不是模型胡说,而是我们一次性问了它一个连人都要想半天的问题。”真正的解法:把任务拆到AI没有想象空间的粒度。一个复杂的ToB销售问题,我们拆成117个原子级任务——检索、抽取、比对、校验……每个任务边界清晰、可验证,幻觉率趋近于零。
落地工具包:你带回去就能用
BVAL方法论:对齐“战略-价值-实施-组织”四维,识别高ROI场景
AI场景价值评估矩阵:避免“为了AI而AI”
闭环验证六步法:小切口、快迭代、低成本验证
现场工作坊:企业家提出真实场景,专家当场提炼战略、组织变革路径和技术方案
真实案例:已跑通
AI故障大师:将专家经验24小时在线赋能,停机损失减少30%以上;
AI销售教练:用MEDDIC方法论+智能体,复刻顶级销售决策链,赢单率显著提升(零碳等复杂行业已验证)。
人力资源重构:AI时代的“炸开HR部”
AI时代,人力资源部不再是“支持部门”,而是战略引擎。中国人力资源开发研究会副会长兼智能分会创始会长、紫光集团战略咨询委员会主任委员刘辉,将系统阐述:数字员工如何普及?智能体如何赋能个体?传统HR如何被重构为AI赋能系统?——这不是未来学,这是正在发生的组织革命。
谁应该来学?
董事长、CEO、CXO——AI转型必须是一号位工程,只有你能推动组织与权力重构;
人力、财经、供应链、研发、销售、制造体系一把手——找到本领域AI落地的“第一刀”;
企业年营收10亿以上,或B+轮以上融资——我们已经默认你过了“要不要AI”的阶段。
扬帆配资提示:文章来自网络,不代表本站观点。